엑셀 중복값 삭제 실수 없이 하는 방법
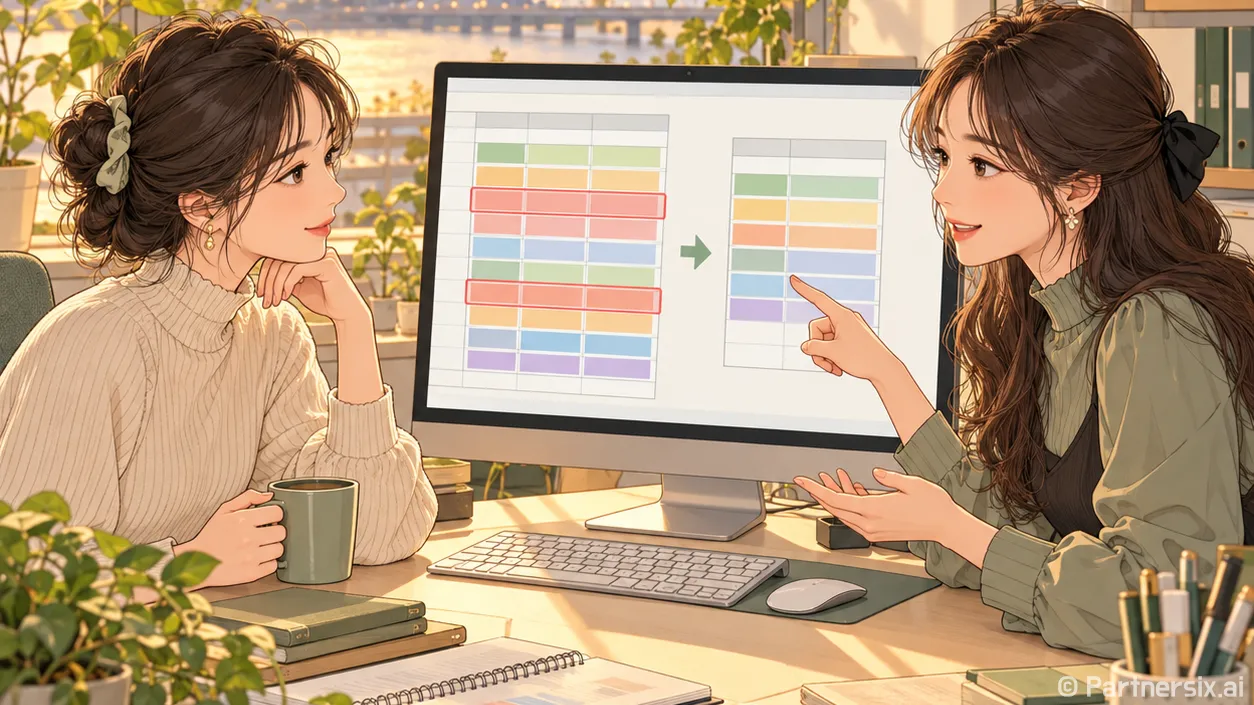
얼마 전 고객 명단을 받았는데, 같은 이름이 여러 번 보였습니다. 이름만 기준으로 지웠다면 동명이인까지 사라질 뻔했죠. 엑셀 중복값 삭제는 버튼을 누르는 일보다 ‘무엇을 같은 데이터로 볼지’ 정하는 일이 더 중요합니다.
삭제 전에 중복 기준부터 정하세요
예를 들어 이름, 전화번호, 주문일이 있는 표를 생각해 볼게요. 이름 열만 기준으로 삼으면 이름이 같은 행은 전화번호가 달라도 중복으로 처리됩니다. 이름과 전화번호를 함께 기준으로 삼으면 두 값이 모두 같은 행만 중복으로 처리됩니다.
주문 기록이라면 같은 고객이 여러 번 주문한 것이 정상일 수 있습니다. 이때 고객 이름으로 중복을 지우면 실제 주문까지 없어집니다. 고객 명단에는 전화번호나 고객번호가, 주문 기록에는 주문번호가 더 적절한 기준인 경우가 많습니다.
또 하나 중요한 점은 남길 행입니다. 엑셀의 중복 제거 기능은 중복된 묶음에서 첫 번째 행을 남깁니다. 같은 고객의 기록 중 가장 최근 수정본을 남겨야 한다면, 원본을 복사한 뒤 수정일 열을 최신순으로 정렬하고 제거 작업을 진행하세요. 정렬 방향에 따라 살아남는 정보가 달라집니다.
중복된 항목 제거 버튼을 누르는 순서
먼저 원본 시트를 복사해 두세요. 중복 제거는 실제 데이터를 삭제하므로, 결과가 예상과 다를 때 원본과 비교할 수 있어야 합니다. 표 안의 셀 하나를 클릭하거나 데이터 범위 전체를 선택한 뒤 상단의 데이터 탭에서 중복된 항목 제거를 누릅니다.
대화 상자가 열리면 선택된 범위가 맞는지 보고, 첫 행이 열 이름이라면 ‘머리글 포함’ 항목도 확인하세요. 이어서 중복을 판단할 열에만 체크합니다. 모든 열을 선택하면 선택한 열의 값이 모두 같은 행만 제거됩니다. 이름과 전화번호를 기준으로 삼고 싶다면 두 열만 체크하면 됩니다.
예를 들어 ‘김민수, 010-1234-5678, 3월 2일’과 ‘김민수, 010-1234-5678, 4월 8일’이라는 두 행이 있다고 해볼게요. 이름과 전화번호만 체크하면 한 행이 제거됩니다. 주문일도 체크하면 날짜가 달라 두 행이 모두 남습니다. 체크하지 않은 열도 중복 행과 함께 삭제되므로, 날짜나 메모를 남겨야 한다면 특히 신중해야 합니다.
확인을 누르면 제거된 중복 항목 수와 남은 고유 항목 수가 표시됩니다. 숫자가 예상보다 크다면 곧바로 실행 취소를 하고 기준 열을 다시 확인하세요. 작업 직후라면 Ctrl+Z로 되돌릴 수 있지만, 이후 여러 작업을 진행할 예정이라면 복사해 둔 원본이 더 확실한 비교 대상입니다.
지우기 전에 눈으로 확인하는 방법
중복 여부가 애매한 명단이라면 먼저 색으로 표시하는 편이 편합니다. 확인할 열을 선택하고 홈 탭의 조건부 서식에서 셀 강조 규칙, 중복 값을 차례로 선택하세요. 같은 값이 있는 셀이 표시되므로 동명이인이나 공동 전화번호처럼 따로 확인할 항목을 찾기 쉽습니다.
다만 색이 칠해진 셀을 전부 삭제 대상으로 보면 안 됩니다. 조건부 서식은 반복된 값을 표시할 뿐, 어떤 행을 남길지 결정하지 않습니다. 서로 다른 사람에게 같은 대표 전화번호가 입력된 경우처럼 값은 같아도 기록은 각각 필요한 사례가 있습니다.
원본을 건드리지 않고 고유 목록만 따로 보고 싶다면 UNIQUE 함수도 쓸 수 있습니다. 예를 들어 A2부터 A100까지의 이름에서 한 번씩만 표시되는 목록은 빈 셀에 =UNIQUE(A2:A100)을 입력하면 됩니다. Microsoft 365와 Excel 2021·2024에서 사용할 수 있으며, 이 방식은 원본 행을 삭제하지 않습니다.
여기서 UNIQUE의 기본 결과는 ‘중복을 한 개만 남긴 목록’입니다. 한 번만 등장한 값만 골라내는 것과는 다릅니다. 이름과 전화번호를 한 묶음으로 비교하려면 =UNIQUE(A2:B100)처럼 두 열을 함께 지정할 수 있습니다. 결과가 펼쳐질 공간은 비워 두어야 합니다.
삭제했는데 중복이 남는다면
화면에는 같은 이름처럼 보여도 앞뒤에 공백이 섞여 있으면 다른 값으로 취급될 수 있습니다. 외부 시스템에서 가져온 명단은 띄어쓰기, 보이지 않는 문자, 전화번호 표기가 제각각인 일이 흔합니다. ‘01012345678’과 ‘010-1234-5678’도 엑셀에서 그대로는 같은 문자열이 아닙니다.
이럴 때는 원본 옆에 작업용 열을 만들어 값을 통일한 뒤 비교하는 편이 안전합니다. 일반적인 앞뒤 공백은 TRIM 함수로 다듬을 수 있고, 전화번호의 하이픈은 SUBSTITUTE 함수로 제거할 수 있습니다. 함수 결과를 확인한 뒤 그 작업용 열을 기준으로 중복을 판단하면 놓친 항목이 줄어듭니다.
반대로 중복이 너무 많이 지워졌다면 기준 열을 너무 적게 선택했을 가능성이 큽니다. 이름만 체크한 상태에서 같은 이름의 다른 사람을 하나로 합친 경우가 대표적이죠. 원본과 남은 행을 비교하면서 고객번호, 전화번호, 주문번호 중 실제로 한 건을 구별하는 값이 무엇인지 다시 고르는 게 좋습니다.
명단을 한 번만 손보는 일이라면 데이터 탭의 중복된 항목 제거가 빠릅니다. 주기적으로 새 자료가 들어오고 원본도 보존해야 한다면 UNIQUE로 별도 목록을 만드는 방식이 더 편할 수 있습니다. 결국 좋은 결과는 기능의 속도보다, 남겨야 할 한 행을 먼저 분명히 정하는 데서 나옵니다.